Меня триггерит фраза:
Я пробовал с ИИ делать, всё плохо получается.
Давайте разберём, что вообще влияет на качество ответа модели.
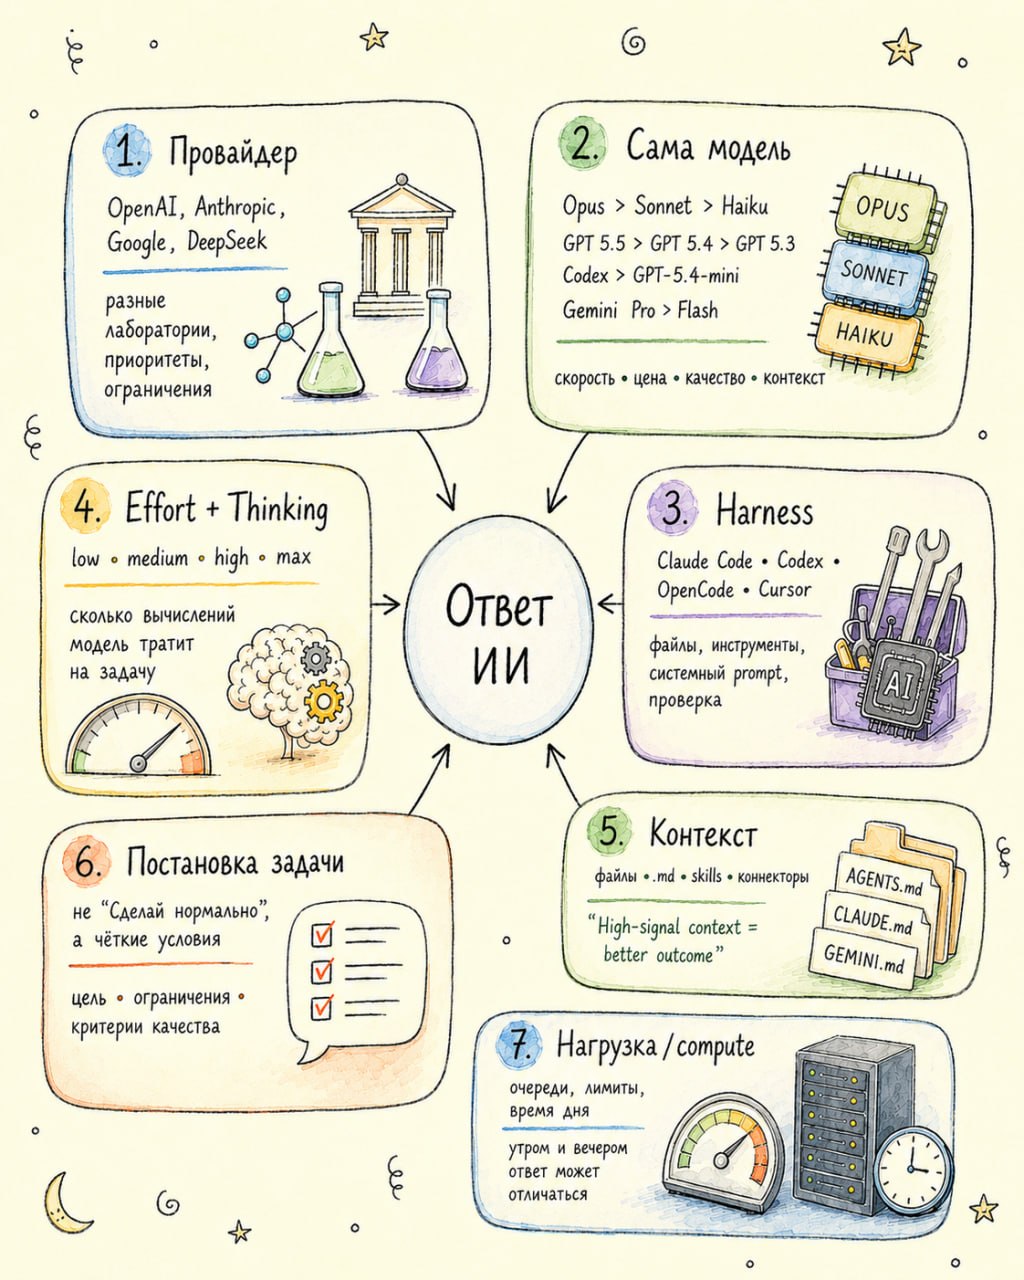
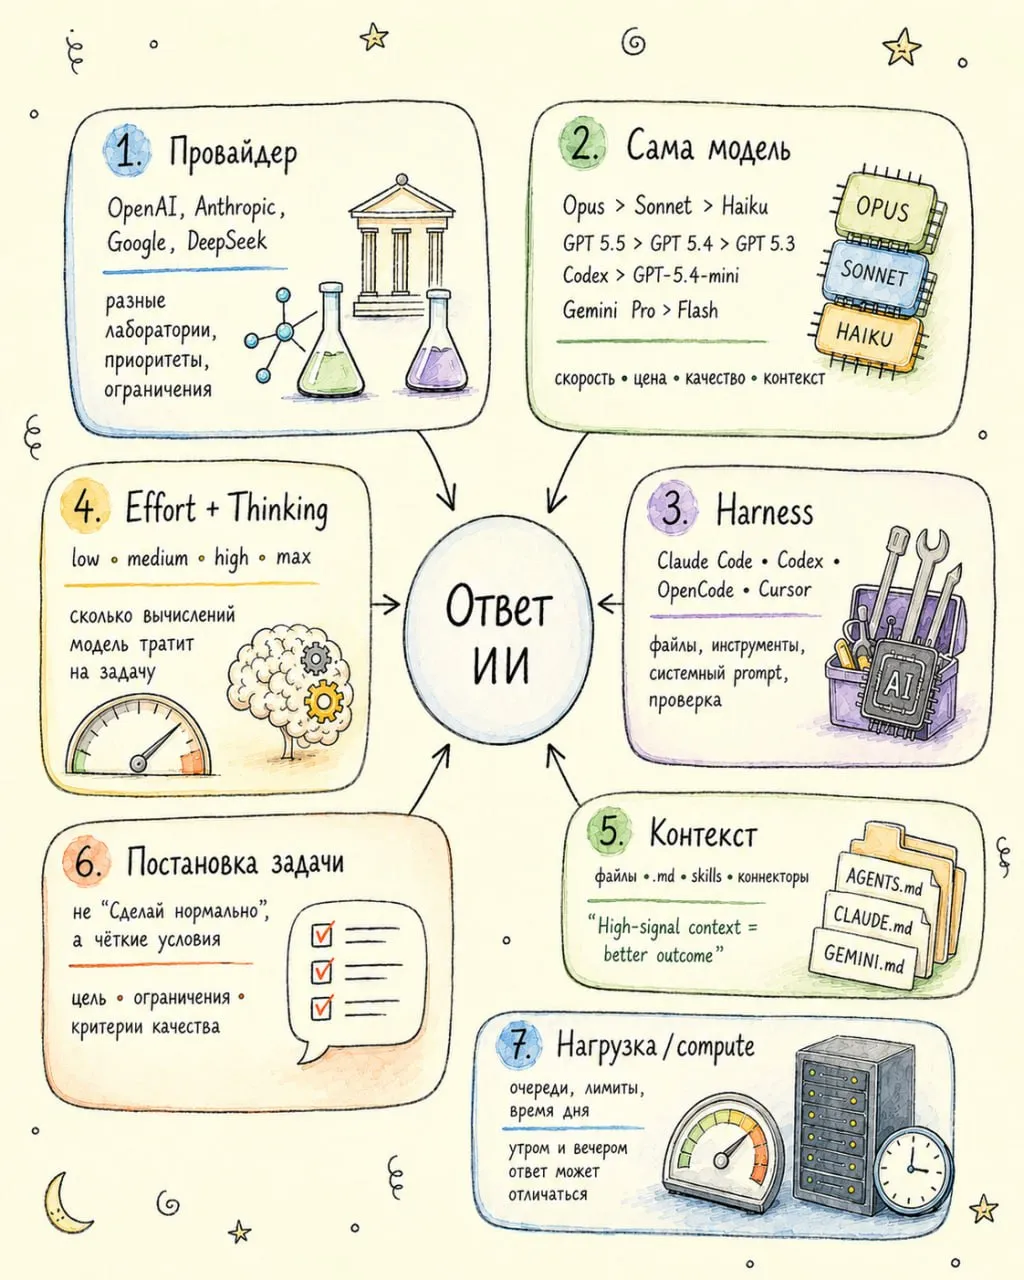
1. Провайдер модели
OpenAI, Anthropic, Google, DeepSeek и другие — это разные лаборатории, разные архитектурные решения, разные приоритеты и разные ограничения.
Один провайдер сильнее в коде, другой — в длинном контексте, третий — в мультимодальности, четвёртый — в цене и скорости. Сравнивать их как «ИИ в целом» — всё равно что один раз поесть в аэропорту и сделать вывод о всей мировой кухне.
2. Сама модель
Даже внутри одного провайдера модели сильно отличаются: у Anthropic это линейка Opus — Sonnet — Haiku, у OpenAI — старшие и mini-версии GPT и Codex, у Google — Pro и Flash. Практически у каждого поставщика есть и быстрые дешёвые модели, и медленные дорогие.
У них разная глубина рассуждений, контекст, скорость, цена, склонность к ошибкам, качество кода, стиль письма и работа с инструкциями.
3. Harness вокруг модели
Harness — это обвязка поверх модели: Claude Code, Codex, OpenCode, Cursor и другие инструменты. Слой, который решает:
- какие файлы дать модели;
- как собрать контекст;
- какие инструменты ей доступны;
- как она может редактировать код;
- как она проверяет результат;
- какие системные инструкции у неё уже зашиты.
Одна и та же модель в голом чате и внутри хорошего coding harness даёт заметно разный результат.
4. Effort и thinking
У многих моделей есть уровень усилия — low, medium, high, max — плюс отдельные режимы reasoning и thinking. Это буквально настройка того, сколько вычислений модель готова потратить на задачу. На low она даёт быстрый поверхностный ответ, на high и max — дольше думает, проверяет гипотезы, держит больше условий.
5. Ваши навыки работы с контекстом
Контекст — половина результата. Что вы дали модели? Какие файлы? Какие
ограничения? Какие примеры хорошего результата? Есть ли AGENTS.md,
CLAUDE.md, GEMINI.md, что там лежит и на какие файлы они ссылаются? Есть ли
скиллы и коннекторы к нужным сервисам?
Если у модели нет нужного контекста, она достроит картину так, как сочтёт нужным.
Good context engineering means finding the smallest possible set of high-signal tokens that maximize the likelihood of some desired outcome.
6. То, как вы общаетесь с моделью
Есть разница между «сделай нормально» и «вот задача, вот контекст, вот ограничения, вот что считаем хорошим результатом, вот чего точно не делать; сначала проверь файлы, потом предложи план, после этого внеси минимальные правки».
ИИ очень чувствителен к постановке задачи. А по моим наблюдениям, люди и другим людям инструкции давать не умеют — что уж говорить про модель.
7. Нагрузка и доступный compute
У моделей есть реальная инфраструктура на реальных серверах, а значит — очереди, лимиты и стоимость вычислений. Когда нагрузка высокая, сервисы могут упрощать расчёты и включать более дешёвые режимы, резать глубину рассуждений, ограничивать контекст или вести себя менее стабильно. И почти никогда вы об этом не узнаете.
Поэтому один и тот же запрос утром и вечером иногда даёт разный уровень ответа.
Что в итоге влияет на ответ
Изменение даже одной переменной даёт другой результат:
- провайдер модели;
- конкретная модель;
- harness вокруг неё и его системный промт;
- выбранный effort и включён ли thinking;
- ваши навыки работы с контекстом:
.md-файлы, скиллы, коннекторы; - то, как вы формулируете задачу;
- время суток — compute серверов ограничен, и при пиковой нагрузке расчёты упрощают.
Поэтому «я попробовал этот ваш ИИ, он сделал плохо» — запрос во вселенную, а не постановка задачи. Хотите конструктивного разговора — называйте параметры, тогда и ответ будет по делу.